使用 Atlas 管理数据库 Schema 变更
数据库 Schema 变更管理痛点
后端开发时经常会涉及到表结构变更,表结构变更是重要且高危的操作,所以必须要有审核过程。
一般后端的上线流程是这样,会先通过 SQL 审计平台提交 SQL 工单,经过层层审批后,将表结构变更同步到生产环境,然后再上线业务代码。 比如 Yearning、 Archery 这些平台,就支持 SQL 工单审核。
但是当你的数据库实例越来越多,每次上线都要提交几十上百个工单的时候,不管是对开发者还是对审批者来说,都是灾难一样的体验。
更不用说当你忘记提交某个工单,却直接把代码上线了。。。那等来的将是上线事故,滋味可是相当不好受( ̄_ ̄|||)
数据库 Migration 工具 Atlas 介绍
数据库 Migration(迁移)是什么? 数据库 Migration(迁移) 是指对数据库 Schema(结构)进行版本化管理和增量变更的过程。简单来说,就是像管理代码一样管理数据库结构的变化。
针对上面介绍的数据库 Schema 变更管理痛点,我们可以将期望态的表结构与业务代码放在一起,用 Git 来管理。然后用一种数据库 Migration 工具,在每次上线时,将 Git 里保存的表结构,自动同步到生产环境上。
今天介绍的 Altas ,就是这样的工具。
安装 Atlas
我推荐使用 mise来安装并管理 Atlas ,因为它支持 Atlas 的多版本管理。而且通过 mise task 对 Atlas 命令进行自定义封装后,可以极大简化 Atlas 使用复杂度。
有关 mise 的安装使用可以参考 我的这篇博客
安装过程很简单,在项目根目录下的 mise.toml 中定义好如下代码,然后执行 mise install
Atlas 声明式工作流
声明式工作流,讲究的是所见即所得。在代码库中定义好表结构 schema,即建表语句,之后每次字段变更时不需要再单独写 ALTER 语句了,直接表结构 schema 就行。
Atlas 会将你声明好的最新版表结构 schema 直接同步到目标数据库实例上。
这种声明式工作流思想在 K8s 中也有用到。比如用 YAML 文件描述好应用的期望状态,K8s 会负责将应用按照你声明好的 YAML 文件部署到集群上,而你不需要关注具体过程。
接下来介绍一下声明式工作流怎么使用。
首先来看一下我的代码结构,我的项目采用的是 go-zero 框架。
可以看到 order 服务的所有建表语句都放在 app/order/sql/schema 目录下,目前只有两张表。
那么如何让 Atlas 将 orders.sql 和 order_item.sql 同步到目标库中呢?很简单,一条命令就行
其中每个参数的作用如下:
参数 url 为目标数据库地址
参数 to 为存放建表语句即表结构 schema 声明的本地位置
参数 dev-url 为一个与业务无关的、临时的、隔离的数据库实例,Atlas 将其用作沙箱来模拟真实环境。
可以看到 dev-url 参数是 Atlas 实现数据库自动化 Migration 的关键。
在本条命令执行后,Atlas 会干4件事:
atlas schema apply 执行原理
因为我们在 dev-url 中指定的是 docker,所以Atlas 会调用 docker 拉起一个临时数据库实例,然后将本地定义好的表结构 schema 应用到 dev-url 所在的临时库中。
随后 Atlas 会拿 dev-url 所在实例的 schema 与 url 所在目标库实例的 schema 做对比计算。计算出来的差异部分, Atlas 会将其生成 SQL 工单来供我们审批, 你可以选择通过或者拒绝。
如果审批通过,Atlas 会自动将差异部分的 SQL 脚本放在目标库实例上执行,最终达成的效果是目标库的 schema 与本地代码仓库声明的 schema 保持一致。
命令执行完后重置 dev-url 所在实例的 schema。由于在本例中使用的是 docker,所以临时拉起的 docker 容器会自动销毁。
接下来跟我在实际项目中搭建一个声明式工作流:
实际项目中的声明式工作流搭建过程
首先在目标库中新建4张表
CREATE TABLE users ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '用户ID', name VARCHAR(50) NOT NULL COMMENT '用户姓名', PRIMARY KEY (id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户表';CREATE TABLE products ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '商品ID', name VARCHAR(100) NOT NULL COMMENT '商品名称', category VARCHAR(50) NOT NULL COMMENT '商品分类(如:服装类)', unit_price DECIMAL(10, 2) NOT NULL COMMENT '单价', stock INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '剩余库存', PRIMARY KEY (id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='商品表';CREATE TABLE orders ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '订单ID', user_id BIGINT UNSIGNED NOT NULL COMMENT '用户ID', order_amount DECIMAL(10, 2) NOT NULL COMMENT '订单金额', paid_amount DECIMAL(10, 2) NOT NULL COMMENT '支付金额', pay_time DATETIME DEFAULT NULL COMMENT '支付时间', PRIMARY KEY (id), INDEX idx_user_id (user_id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单表';CREATE TABLE order_items ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '详情ID', order_id BIGINT UNSIGNED NOT NULL COMMENT '订单ID', product_id BIGINT UNSIGNED NOT NULL COMMENT '商品ID', quantity INT UNSIGNED NOT NULL COMMENT '商品数量', PRIMARY KEY (id), INDEX idx_order_id (order_id), INDEX idx_product_id (product_id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单详情表';修改本地代码库中的
orders.sql和order_item.sql两个文件CREATE TABLE `orders` ( `id` bigint unsigned NOT NULL AUTO_INCREMENT COMMENT '订单ID', `user_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT '用户ID', `order_amount` decimal(10,2) NOT NULL DEFAULT 0 COMMENT '订单金额', `paid_amount` decimal(10,2) NOT NULL DEFAULT 0 COMMENT '支付金额', `pay_time` datetime DEFAULT NULL COMMENT '支付时间', PRIMARY KEY (`id`), KEY `idx_user_id` (`user_id`) ) ENGINE=InnoDB COMMENT='订单表';CREATE TABLE `order_items` ( `id` bigint unsigned NOT NULL AUTO_INCREMENT COMMENT '详情ID', `order_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT '订单ID', `product_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT '商品ID', `quantity` int unsigned NOT NULL DEFAULT 0 COMMENT '商品数量', PRIMARY KEY (`id`), KEY `idx_order_id` (`order_id`), KEY `idx_product_id` (`product_id`) ) ENGINE=InnoDB COMMENT='订单详情表';可以看到 代码库中的两个 sql 文件与目标库的表结构基本一样,唯独多了
DEFAULT 0,但仅仅如此也会造成表结构差异。幸运的是 Atlas 可以检查到这点,并生成对应的
ALTER语句。在本地代码库根目录新建一个
atlas.hcl文件,填入如下代码# 定义开发测试用的临时沙箱数据库(Dev Database),与业务无关 # PS:因为我本地测试时使用 docker 一直失败,所以这里改成了我自己创建的一个空白库 variable "dev_url" { type = string default = "mysql://root:123456@127.0.0.1:3307/altas_dev" } # 1. 本地开发环境(声明式 Schema 模式) env "order_local" { url = "mysql://root:123456@127.0.0.1:3307/wsl_test" # 目标数据库 src = "file://app/order/sql/schema" # Schema 声明文件路径 dev = var.dev_url # 计算 diff 需要 Dev 数据库 }我们在这个
atlas.hcl文件里,把刚才的 Atlas 命令参数给持久化了,并且跟项目代码一起用 Git 管理。它就像 docker compose 中的
docker-compose.yml文件一样,会帮助我们简化基础命令的使用,同时将我们的操作固化下来,方便重复执行与记忆。接下来我们执行
atlas schema apply --env order_local结果如下所示,Atlas 会等待我们审批,是拒绝(Abort)还是通过(Approve)
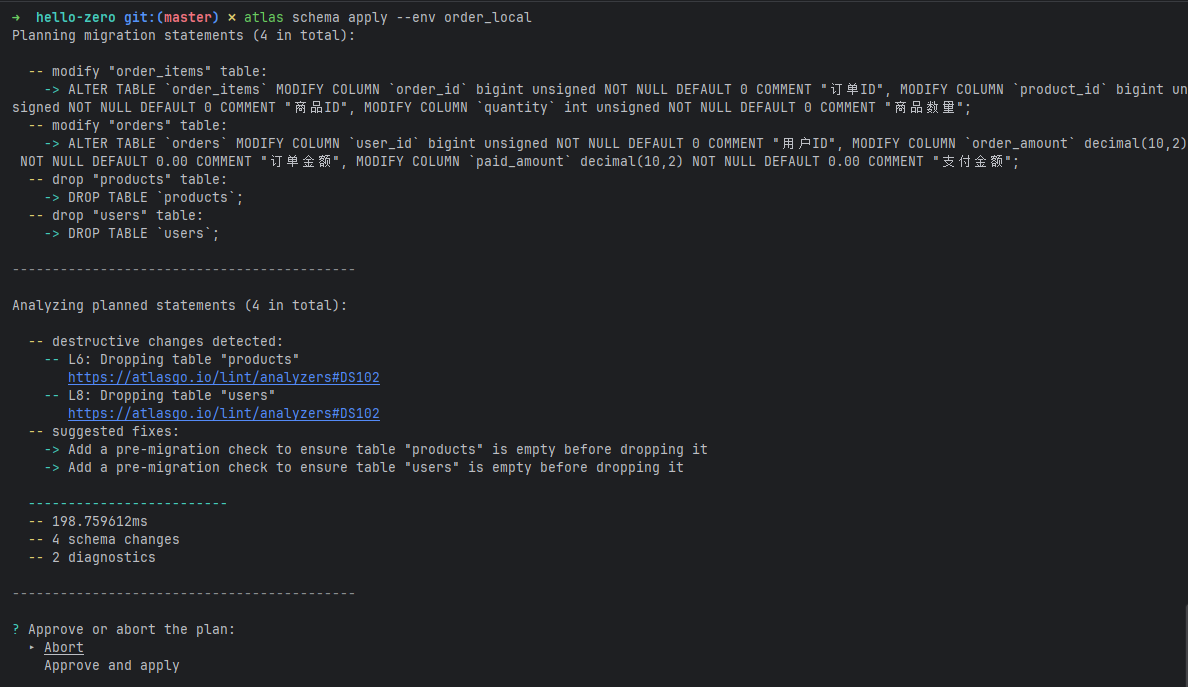
但是我们发现 Atlas 除了生成
orders和order_items两张表的ALTER语句之外,把我们另外两张表(products和users)也DROP掉了。DROP语句可是一个非常高危的操作!!!生产环境这么用可是要完蛋。所以我们接下来要拦截一下DROP语句。拒掉(Abort)刚才的工单。
再次修改 `atlas.hcl` 文件,将 `order_local` 代码块改成下面这样:
# 1. 本地开发环境(声明式 Schema 模式) env "order_local" { url = "mysql://root:123456@127.0.0.1:3307/wsl_test" # 目标数据库 src = "file://app/order/sql/schema" # Schema 声明文件路径 dev = var.dev_url # 计算 diff 需要 Dev 数据库 diff { skip { drop_table = true # 忽略 drop 等高危操作 drop_schema = true } } }在控制台执行如下命令
atlas schema apply --env order_local --dry-run加上 dry-run 参数后代表该命令为“试运行”,所以不会生成实际的工单,也不会对目标库执行任何写入操作。
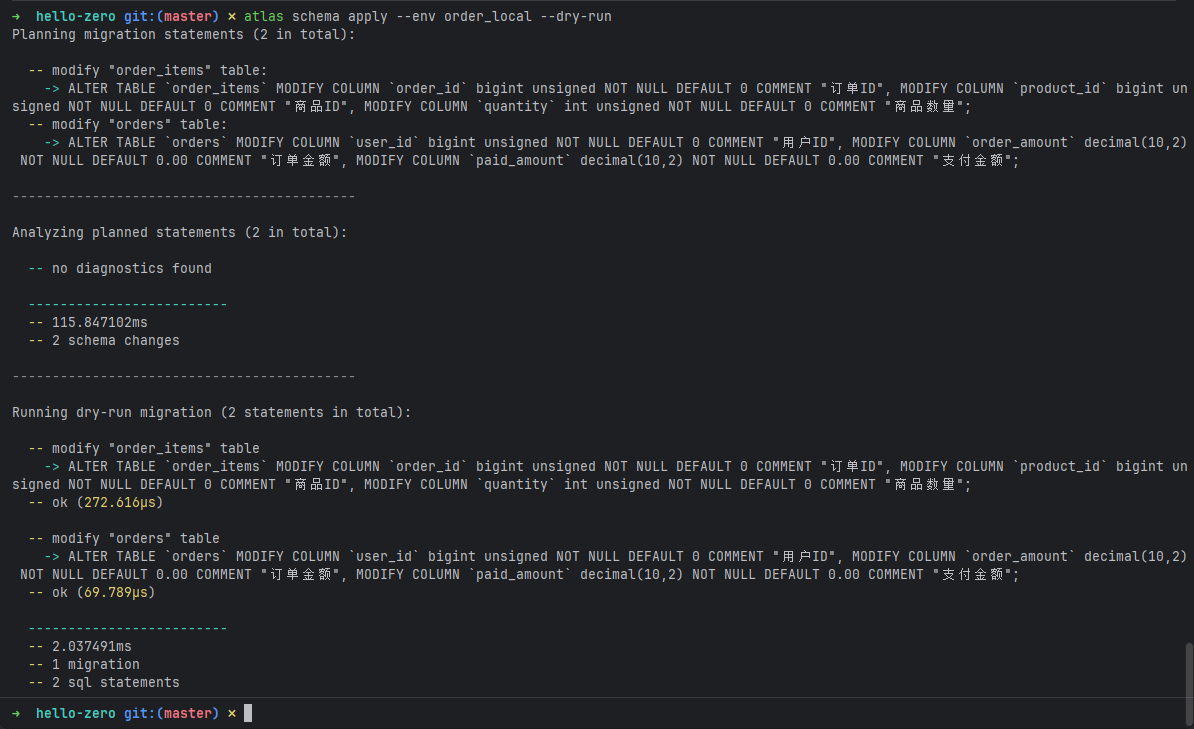
可以看到现在只剩下
ALTER语句了。接下来把 dry-run 参数去掉,再次执行命令,并选择审批通过(Approve),结果如下所示➜ hello-zero git:(master) ✗ atlas schema apply --env order_local Planning migration statements (2 in total): -- modify "order_items" table: -> ALTER TABLE `order_items` MODIFY COLUMN `order_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "订单ID", MODIFY COLUMN `product_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "商品ID", MODIFY COLUMN `quantity` int unsigned NOT NULL DEFAULT 0 COMMENT "商品数量"; -- modify "orders" table: -> ALTER TABLE `orders` MODIFY COLUMN `user_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "用户ID", MODIFY COLUMN `order_amount` decimal(10,2) NOT NULL DEFAULT 0.00 COMMENT "订单金额", MODIFY COLUMN `paid_amount` decimal(10,2) NOT NULL DEFAULT 0.00 COMMENT "支付金额"; ------------------------------------------- Analyzing planned statements (2 in total): -- no diagnostics found ------------------------- -- 119.850006ms -- 2 schema changes ------------------------------------------- Applying approved migration (2 statements in total): -- modify "order_items" table -> ALTER TABLE `order_items` MODIFY COLUMN `order_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "订单ID", MODIFY COLUMN `product_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "商品ID", MODIFY COLUMN `quantity` int unsigned NOT NULL DEFAULT 0 COMMENT "商品数量"; -- ok (47.962508ms) -- modify "orders" table -> ALTER TABLE `orders` MODIFY COLUMN `user_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "用户ID", MODIFY COLUMN `order_amount` decimal(10,2) NOT NULL DEFAULT 0.00 COMMENT "订单金额", MODIFY COLUMN `paid_amount` decimal(10,2) NOT NULL DEFAULT 0.00 COMMENT "支付金额"; -- ok (22.286367ms) ------------------------- -- 70.423409ms -- 1 migration -- 2 sql statements
整个声明式工作流就跑通了。
另外由于我使用的是 go-zero 框架,model 层代码也是由 sql 文件生成的。
所以每次表结构变更时,只需改 sql 文件这一处约束就行,model 层代码与目标库 schema 全都靠自动化工具自己搞定,完全不用手写 ALTER 语句,怎么样是不是很方便?
Atlas 版本化工作流
上面讲的声明式工作流,其实只适合本地开发环境或者测试环境。因为它追求速度,允许灵活试错。 但是生产环境要求严格审计,每次变更需可追溯、可回滚,且通常要经过 Code Review, 所以最适合生产环境的是下面要讲的版本化工作流。
由于版本化工作流涉及到的命令比较多,所以我们直接在实际项目中搭建一个版本化工作流来看看它到底怎么用:
实际项目中的版本化工作流搭建过程
默认设置下,版本化工作流要求目标库从零开始版本化管理,所以我们先新建一个空白库
CREATE DATABASE wsl_prod;接下来在
atlas.hcl文件中追加如下内容# 2. 团队协作/生产环境(版本化 Migration 模式) env "order_prod" { url = "mysql://root:123456@127.0.0.1:3307/wsl_prod" # 目标数据库 src = "file://app/order/sql/schema" # Schema 声明文件路径(生成 migration 时比对的源) dev = var.dev_url # 计算 diff 需要 Dev 数据库 # 迁移脚本存储目录 (存放生成的 202608061000_init.sql 等) migration { dir = "file://app/order/sql/migrations" } diff { skip { drop_table = true # 忽略 drop 等高危操作 drop_schema = true } } }可以看到版本化工作流配置中,多了一个 migration 设置项,此设置项指定了一个目录,即每个版本的 SQL 迁移脚本的本地存放目录。
目前我本地环境这个目录下没有任何文件。
接下来我们执行
atlas migrate diff命令,生成初始版本的 SQL 迁移脚本。这个命令要求必须要指定一个 “name” 参数,作用就类似 git 中的 commit message,由于是第一个初始版本,我们起名为 “init” 就行。
完整命令如下:
atlas migrate diff init --env order_prod接下来检查一下 app/order/sql/migrations 目录,看下有什么变化。
➜ hello-zero git:(master) ✗ cd app/order/sql/migrations ➜ migrations git:(master) ✗ tree . ├── 20260812124610_init.sql └── atlas.sum 1 directory, 2 files ➜ migrations git:(master) ✗ head -v 20260812124610_init.sql atlas.sum ==> 20260812124610_init.sql <== -- Create "order_items" table CREATE TABLE `order_items` ( `id` bigint unsigned NOT NULL AUTO_INCREMENT COMMENT "详情ID", `order_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "订单ID", `product_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "商品ID", `quantity` int unsigned NOT NULL DEFAULT 0 COMMENT "商品数量", PRIMARY KEY (`id`), INDEX `idx_order_id` (`order_id`), INDEX `idx_product_id` (`product_id`) ) CHARSET utf8mb4 COLLATE utf8mb4_0900_ai_ci COMMENT "订单详情表"; ==> atlas.sum <== h1:8Tvf8Ew9dndb8OE8KFnpUkLzvrFRNqfpjpRsmFrMIXM= 20260812124610_init.sql h1:r5lPGbbBrNiHjYLpiWNtzkBCCXSQa1Xc094YvIftFWg=可以看到生成了两个文件:
其中
20260812124610_init.sql就是初始版本的迁移脚本。它包含了截至到现在app/order/sql/schema目录下的所有建表语句。而另一个
atlas.sum是一个校验和文件,他的作用是防止人为修改 migrations 目录下的内容。在应用 schema migration 之前,建议通过
atlas migrate lint命令先做一步检查,看下有没有破环性变更或者数据丢失什么的。完整命令与执行输出如下:
➜ hello-zero git:(master) ✗ atlas migrate lint --env order_prod --latest 1 Analyzing changes until version 20260812124610 (1 migration in total): -- analyzing version 20260812124610 -- no diagnostics found -- ok (169.062613ms) ------------------------- -- 559.787789ms -- 1 version ok -- 2 schema changes What's next: Try Atlas Copilot to suggest custom linting rules for your schema → atlas copilot --env order_prod 'Suggest custom linting rules for my schema' Learn more: https://atlasgo.io/lint/rules可以看到没有什么异常,下一步可以直接应用 schema migration 了
执行
atlas migrate apply命令,将 schema migration 应用到生产环境完整命令与执行输出如下:
➜ hello-zero git:(master) ✗ atlas migrate status --env order_prod Migration Status: PENDING -- Current Version: No migration applied yet -- Next Version: 20260812124610 -- Executed Files: 0 -- Pending Files: 1 ➜ hello-zero git:(master) ✗ atlas migrate apply --env order_prod Migrating to version 20260812124610 (1 migrations in total): -- migrating version 20260812124610 -> CREATE TABLE `order_items` ( `id` bigint unsigned NOT NULL AUTO_INCREMENT COMMENT "详情ID", `order_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "订单ID", `product_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "商品ID", `quantity` int unsigned NOT NULL DEFAULT 0 COMMENT "商品数量", PRIMARY KEY (`id`), INDEX `idx_order_id` (`order_id`), INDEX `idx_product_id` (`product_id`) ) CHARSET utf8mb4 COLLATE utf8mb4_0900_ai_ci COMMENT "订单详情表"; -> CREATE TABLE `orders` ( `id` bigint unsigned NOT NULL AUTO_INCREMENT COMMENT "订单ID", `user_id` bigint unsigned NOT NULL DEFAULT 0 COMMENT "用户ID", `order_amount` decimal(10,2) NOT NULL DEFAULT 0.00 COMMENT "订单金额", `paid_amount` decimal(10,2) NOT NULL DEFAULT 0.00 COMMENT "支付金额", `pay_time` datetime NULL COMMENT "支付时间", PRIMARY KEY (`id`), INDEX `idx_user_id` (`user_id`) ) CHARSET utf8mb4 COLLATE utf8mb4_0900_ai_ci COMMENT "订单表"; -- ok (116.676702ms) ------------------------- -- 174.83487ms -- 1 migration -- 2 sql statements ➜ hello-zero git:(master) ✗ atlas migrate status --env order_prod Migration Status: OK -- Current Version: 20260812124610 -- Next Version: Already at latest version -- Executed Files: 1 -- Pending Files: 0我们在
atlas migrate apply命令执行前后,分别执行了一次atlas migrate status命令。它可以查看目标库当前处于哪个版本,并且下一个要执行的是哪个版本。
根据上述命令的执行输出来看,schema migration 已经成功,接下来看看数据库有什么变化:
mysql> use wsl_prod Reading table information for completion of table and column names You can turn off this feature to get a quicker startup with -A Database changed mysql> show tables; +------------------------+ | Tables_in_wsl_prod | +------------------------+ | atlas_schema_revisions | | order_items | | orders | +------------------------+ 3 rows in set (0.02 sec) mysql> desc atlas_schema_revisions; +------------------+-----------------+------+-----+---------+-------+ | Field | Type | Null | Key | Default | Extra | +------------------+-----------------+------+-----+---------+-------+ | version | varchar(255) | NO | PRI | NULL | | | description | varchar(255) | NO | | NULL | | | type | bigint unsigned | NO | | 2 | | | applied | bigint | NO | | 0 | | | total | bigint | NO | | 0 | | | executed_at | timestamp | NO | | NULL | | | execution_time | bigint | NO | | NULL | | | error | longtext | YES | | NULL | | | error_stmt | longtext | YES | | NULL | | | hash | varchar(255) | NO | | NULL | | | partial_hashes | json | YES | | NULL | | | operator_version | varchar(255) | NO | | NULL | | +------------------+-----------------+------+-----+---------+-------+ 12 rows in set (0.02 sec) mysql> select * from atlas_schema_revisions; +----------------+-------------+------+---------+-------+---------------------+----------------+-------+------------+----------------------------------------------+----------------+------------------+ | version | description | type | applied | total | executed_at | execution_time | error | error_stmt | hash | partial_hashes | operator_version | +----------------+-------------+------+---------+-------+---------------------+----------------+-------+------------+----------------------------------------------+----------------+------------------+ | 20260812124610 | init | 2 | 2 | 2 | 2026-08-12 13:53:22 | 7993050 | | | r5lPGbbBrNiHjYLpiWNtzkBCCXSQa1Xc094YvIftFWg= | null | Atlas CLI v1.3.0 | +----------------+-------------+------+---------+-------+---------------------+----------------+-------+------------+----------------------------------------------+----------------+------------------+ 1 row in set (0.00 sec)可以看到
orders和order_items两张表已经成功创建。此外还多创建了一张
atlas_schema_revisions表,里面存放了目标库当前 schema migration 的版本进度。
这就是 Atlas 设计的精妙之处:
在 diff 阶段,它对比的是 app/order/sql/migrations 目录下现存各版本叠加后的 schema 与 app/order/sql/schema 目录下期望版本 schema 之差异。
当出现差异时,在 app/order/sql/migrations 目录下生成新版本的迁移脚本。整个 diff 阶段只在本地做计算,不连接生产库。
在 apply 阶段,会将每个版本的迁移进度记录在目标数据库中,由目标库自行跟踪当前是哪个版本,且下一步需要迁移哪些新版本。
所以 Atlas 天然适合一套代码对接多个数据库实例的场景。比如某些中台类型的项目。此外 diff 阶段不需要连接目标库,也完美符合企业中本地环境不能直连生产库的安全标准。
在实际的企业开发场景中,我们只需在本地环境配置好 diff 阶段,并将 apply 阶段配置到对应的 CI/CD 系统中,就可以实现数据库 schema migration 的自动化。
One more thing:使用 mise task 管理 Atlas
因为 Atlas 命令和参数较多,不便记忆,再加上当我们为各个微服务分库后,导致每个微服务都需要个性化定制命令。因此我们将 Atlas 命令封装在 mise task 中,它就像现代化版本的 Makefile,非常好用。
下面是我的 mise.toml 文件中的 mise task 配置,可供参考:
对于其他的一些类似如何版本化管理非空白的目标库、如何配置 CI/CD 系统等 Atlas 进阶功能,请移步 Atlas 官网做深入了解。
由于篇幅有限,对 Atlas 的分享到这里就结束了。本文只是对 Atlas 最基本的功能做了一些简单的介绍,如有错误,欢迎指正。
感谢阅读。