CREATE TABLE disburse (
id BIGINT PRIMARY KEY AUTO_INCREMENT COMMENT '主键ID',
disburse_date DATE NOT NULL COMMENT '放款日期',
amount DECIMAL(15, 2) NOT NULL COMMENT '放款金额'
) ENGINE=InnoDB COMMENT='放款记录表';
CREATE TABLE repay (
id BIGINT PRIMARY KEY AUTO_INCREMENT COMMENT '主键ID',
repay_date DATE NOT NULL COMMENT '还款日期',
amount DECIMAL(15, 2) NOT NULL COMMENT '还款金额'
) ENGINE=InnoDB COMMENT='还款记录表';
有两种写法,我简称为 横着写 或者 竖着写。 横着写就是用 join ,竖着写就是用 union all ,下面请看代码。
SELECT a.stat_date, a.disburse_amount, b.repay_amount
FROM (
SELECT disburse_date AS stat_date, SUM(amount) AS disburse_amount
FROM disburse
GROUP BY disburse_date
) AS a
JOIN (
SELECT repay_date AS stat_date, SUM(amount) AS repay_amount
FROM repay
GROUP BY repay_date
) b ON a.stat_date = b.stat_date;
SELECT stat_date, SUM(disburse_amount) AS disburse_amount, SUM(repay_amount) AS repay_amount
FROM (
SELECT disburse_date AS stat_date, SUM(amount) AS disburse_amount, 0 AS repay_amount
FROM disburse
GROUP BY disburse_date
UNION
SELECT repay_date AS stat_date, 0 AS disburse_amount, SUM(amount) AS repay_amount
FROM repay
GROUP BY repay_date
) t
GROUP BY stat_date;
我为什么说这个 join 写法有坑呢?因为可能某天有放款但是没还款;或者反过来,有还款没放款。那么在用日期关联的时候,就可能会丢数据,不管你是把 join 改成 left join 还是 right join 都解决不了问题。
下面是针对这中 join 写法的两种优化版,解决了上述问题
SELECT t.stat_date, IFNULL(a.disburse_amount, 0) AS disburse_amount, IFNULL(b.repay_amount, 0) AS repay_amount
FROM (
SELECT DISTINCT stat_date
FROM (
SELECT disburse_date as stat_date FROM disburse
UNION ALL
SELECT repay_date as stat_date FROM repay
) AS all_date
) AS t
LEFT JOIN (
SELECT disburse_date AS stat_date, SUM(amount) AS disburse_amount
FROM disburse
GROUP BY disburse_date
) AS a ON t.stat_date = a.stat_date
LEFT JOIN (
SELECT repay_date AS stat_date, SUM(amount) AS repay_amount
FROM repay
GROUP BY repay_date
) b ON t.stat_date = b.stat_date;
SELECT COALESCE(a.stat_date, b.stat_date) AS stat_date, IFNULL(a.disburse_amount, 0) AS disburse_amount, IFNULL(b.repay_amount, 0) AS repay_amount
FROM (
SELECT disburse_date AS stat_date, SUM(amount) AS disburse_amount
FROM disburse
GROUP BY disburse_date
) AS a
FULL JOIN (
SELECT repay_date AS stat_date, SUM(amount) AS repay_amount
FROM repay
GROUP BY repay_date
) b ON a.stat_date = b.stat_date;
第一种优化版写法,新加了一张全日期的日期表,作为主表,然后 left join 另外两个表。第二种写法是用 full join ,即全外连接。 两种写法都有个弊端,那就是都会存在空值的情况,你可以看到我在 SELECT 中大量使用了 COALESCE、 IFNULL 等函数对空值做特殊处理。 而且在性能方面,两种写法都很糟糕。一个引入了一张额外的表,且写法很啰嗦。一种引入了 full join ,这是一种性能很差的语法,且有些数据库不支持。 简而言之,遇到这种需求, union all 写法是最优解。
CREATE TABLE install (
id BIGINT PRIMARY KEY AUTO_INCREMENT COMMENT '主键ID',
device_id VARCHAR(100) NOT NULL COMMENT '设备唯一标识',
install_time DATETIME(6) NOT NULL COMMENT '安装时间(精确到微秒)'
) ENGINE=InnoDB COMMENT='安装表';
CREATE TABLE register (
id BIGINT PRIMARY KEY AUTO_INCREMENT COMMENT '用户ID/主键',
device_id VARCHAR(100) NOT NULL COMMENT '设备唯一标识',
register_time DATETIME(6) NOT NULL COMMENT '注册时间(精确到微秒)'
) ENGINE=InnoDB COMMENT='用户表';
注册数是来自安装数,所以肯定小于等于安装数,就像漏斗一样。但是这个漏斗的出口是随着时间变化,越来越粗的。 所以这种需求一般都会要求一次性查看多个时期内的转化数据。比如上文提到的T0安装数,即用户安装当天即完成注册的数量;T1安装数,即用户安装当天或第二天完成注册的总数量。 一般遇到这种需求,没有经验的小白先不要慌(其实我当时已经有一点想骂街了)。他的核心解决思路,其实就是两表 join 后, 在 CASE 函数里用两个时间字段做对比。一个不变的时间,一个变化的时间。 拿本例来说,不变的时间就是安装时间,变化的时间就是注册时间。下面请看代码
SELECT DATE(i.install_time) AS install_date,
COUNT(DISTINCT i.device_id) AS install_num,
COUNT(DISTINCT CASE WHEN TIMESTAMPDIFF(HOUR, i.install_time, r.register_time) BETWEEN 0 AND 24 THEN r.id ELSE NULL END) AS register_in_24hour,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 0 THEN r.id ELSE NULL END) AS register_t0,
COUNT(DISTINCT CASE WHEN DATE(r.register_time) = DATE(i.install_time) AND TIME(r.register_time) < '12:00:00' THEN r.id ELSE NULL END) AS register_t0_before_12,
COUNT(DISTINCT CASE WHEN DATE(r.register_time) = DATE(i.install_time) AND TIME(r.register_time) < '18:00:00' THEN r.id END) AS register_t0_before_18,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 1 THEN r.id ELSE NULL END) AS register_t1,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 30 THEN r.id ELSE NULL END) AS register_t30
FROM install AS i
LEFT JOIN register AS r ON i.device_id = r.device_id
GROUP BY DATE(i.install_time)
因为数据库有着丰富的时间日期处理函数,所以理论上上面的写法会有多个变种,但是核心思路不会变。 再进阶一点,上面的SQL是按日统计的,如果老板想按照周维度或者月维度去看这个报表,该怎么统计?其实简单换一下 group by 条件就好了,下面请看代码
SELECT CONCAT(MIN(DATE(i.install_time)),"~",MAX(DATE(i.install_time))) AS install_date,
COUNT(DISTINCT i.device_id) AS install_num,
COUNT(DISTINCT CASE WHEN TIMESTAMPDIFF(HOUR, i.install_time, r.register_time) BETWEEN 0 AND 24 THEN r.id ELSE NULL END) AS register_in_24hour,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 0 THEN r.id ELSE NULL END) AS register_t0,
COUNT(DISTINCT CASE WHEN DATE(r.register_time) = DATE(i.install_time) AND TIME(r.register_time) < '12:00:00' THEN r.id ELSE NULL END) AS register_t0_before_12,
COUNT(DISTINCT CASE WHEN DATE(r.register_time) = DATE(i.install_time) AND TIME(r.register_time) < '18:00:00' THEN r.id END) AS register_t0_before_18,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 1 THEN r.id ELSE NULL END) AS register_t1,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 30 THEN r.id ELSE NULL END) AS register_t30
FROM install AS i
LEFT JOIN register AS r ON i.device_id = r.device_id
GROUP BY YEARWEEK(i.install_time, 1);
SELECT DATE_FORMAT(install_time, '%Y-%m') AS install_date,
COUNT(DISTINCT i.device_id) AS install_num,
COUNT(DISTINCT CASE WHEN TIMESTAMPDIFF(HOUR, i.install_time, r.register_time) BETWEEN 0 AND 24 THEN r.id ELSE NULL END) AS register_in_24hour,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 0 THEN r.id ELSE NULL END) AS register_t0,
COUNT(DISTINCT CASE WHEN DATE(r.register_time) = DATE(i.install_time) AND TIME(r.register_time) < '12:00:00' THEN r.id ELSE NULL END) AS register_t0_before_12,
COUNT(DISTINCT CASE WHEN DATE(r.register_time) = DATE(i.install_time) AND TIME(r.register_time) < '18:00:00' THEN r.id END) AS register_t0_before_18,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 1 THEN r.id ELSE NULL END) AS register_t1,
COUNT(DISTINCT CASE WHEN DATEDIFF(DATE(r.register_time), DATE(i.install_time)) BETWEEN 0 AND 30 THEN r.id ELSE NULL END) AS register_t30
FROM install AS i
LEFT JOIN register AS r ON i.device_id = r.device_id
GROUP BY DATE_FORMAT(install_time, '%Y-%m');
CREATE TABLE users (
id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '用户ID',
name VARCHAR(50) NOT NULL COMMENT '用户姓名',
PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户表';
CREATE TABLE products (
id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '商品ID',
name VARCHAR(100) NOT NULL COMMENT '商品名称',
category VARCHAR(50) NOT NULL COMMENT '商品分类(如:服装类)',
unit_price DECIMAL(10, 2) NOT NULL COMMENT '单价',
stock INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '剩余库存',
PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='商品表';
CREATE TABLE orders (
id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '订单ID',
user_id BIGINT UNSIGNED NOT NULL COMMENT '用户ID',
order_amount DECIMAL(10, 2) NOT NULL COMMENT '订单金额',
paid_amount DECIMAL(10, 2) NOT NULL COMMENT '支付金额',
pay_time DATETIME DEFAULT NULL COMMENT '支付时间',
PRIMARY KEY (id),
INDEX idx_user_id (user_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单表';
CREATE TABLE order_items (
id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '详情ID',
order_id BIGINT UNSIGNED NOT NULL COMMENT '订单ID',
product_id BIGINT UNSIGNED NOT NULL COMMENT '商品ID',
quantity INT UNSIGNED NOT NULL COMMENT '商品数量',
PRIMARY KEY (id),
INDEX idx_order_id (order_id),
INDEX idx_product_id (product_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='订单详情表';
这些表之间的对应关系如下
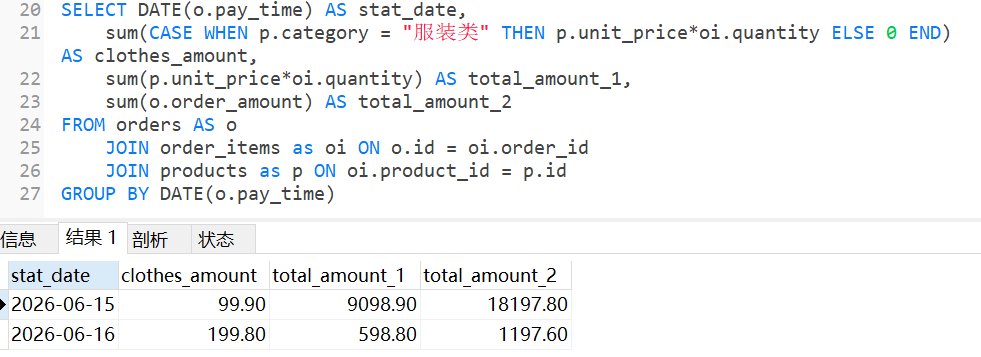
我们先来看一下测试数据,执行如下查询
SELECT o.order_amount, o.paid_amount, o.pay_time, oi.order_id, oi.product_id,
oi.quantity, p.`name`, p.category, p.unit_price
FROM orders AS o
JOIN order_items as oi ON o.id = oi.order_id
JOIN products as p ON oi.product_id = p.id
SELECT DATE(o.pay_time) AS stat_date,
sum(CASE WHEN p.category = "服装类" THEN p.unit_price*oi.quantity ELSE 0 END) /
sum(p.unit_price*oi.quantity) AS rate
FROM orders AS o
JOIN order_items as oi ON o.id = oi.order_id
JOIN products as p ON oi.product_id = p.id
GROUP BY DATE(o.pay_time)
SELECT DATE(o.pay_time) AS stat_date,
sum(CASE WHEN p.category = "服装类" THEN p.unit_price*oi.quantity ELSE 0 END) /
sum(CASE WHEN oi.rn = 1 THEN o.paid_amount ELSE 0 END) AS rate
FROM orders AS o
JOIN (
SELECT order_id, product_id, quantity,
ROW_NUMBER() OVER(PARTITION BY order_id ORDER BY id asc) as rn
FROM order_items
) oi ON o.id = oi.order_id
JOIN products as p ON oi.product_id = p.id
GROUP BY DATE(o.pay_time);
SELECT DATE(o.pay_time) AS stat_date,
SUM(CASE WHEN p.category = '服装类' THEN p.unit_price * oi.quantity ELSE 0 END) /
SUM(CASE WHEN oi.first_item = 1 THEN o.paid_amount ELSE 0 END) AS rate
FROM orders AS o
JOIN (
SELECT a.order_id, a.product_id, a.quantity,
CASE WHEN a.id = MIN(b.id) THEN 1 ELSE 0 END AS first_item
FROM order_items a
LEFT JOIN order_items b ON a.order_id = b.order_id AND a.id >= b.id
GROUP BY a.order_id, a.product_id, a.quantity, a.id
) oi ON o.id = oi.order_id
JOIN products AS p ON oi.product_id = p.id
GROUP BY DATE(o.pay_time);
虽然 MySQL 低版本中不支持窗口函数,但是却可以通过非等值连接的写法来实现与 row_number() 一样的效果,对应的 SQL 我也贴在上面了。
CTE 简单来说就是用 WITH 语句创建的子查询视图,它只是临时存在,可供后续查询时引用,并在SQL执行结束时销毁。它的语法长这样 WITH cte_name AS ( ... )
我们可以用 CTE 写法来改造一下上面的窗口函数子查询版本SQL
SELECT DATE(o.pay_time) AS stat_date,
sum(CASE WHEN p.category = "服装类" THEN p.unit_price*oi.quantity ELSE 0 END) /
sum(CASE WHEN oi.rn = 1 THEN o.paid_amount ELSE 0 END) AS rate
FROM orders AS o
JOIN (
SELECT order_id, product_id, quantity,
ROW_NUMBER() OVER(PARTITION BY order_id ORDER BY id asc) as rn
FROM order_items
) oi ON o.id = oi.order_id
JOIN products as p ON oi.product_id = p.id
GROUP BY DATE(o.pay_time);
WITH oi AS (
SELECT order_id, product_id, quantity,
ROW_NUMBER() OVER(PARTITION BY order_id ORDER BY id asc) as rn
FROM order_items
),
oip AS (
SELECT oi.*,
CASE WHEN p.category = "服装类" THEN p.unit_price*oi.quantity ELSE 0 END AS clothes_amount
FROM oi JOIN products as p ON oi.product_id = p.id
)
SELECT DATE(o.pay_time) AS stat_date,
sum(oip.clothes_amount) /
sum(CASE WHEN oip.rn = 1 THEN o.paid_amount ELSE 0 END) AS rate
FROM orders AS o
JOIN oip ON o.id = oip.order_id
GROUP BY DATE(o.pay_time);
SELECT
"2026-01-10",
SUM(g.face_value) - COALESCE(SUM(u.used_amount), 0) AS active_balance
FROM (
SELECT id, face_value, activated_at, expired_at
FROM gift_card
) g
LEFT JOIN (
SELECT gift_card_id, DATE(used_at) AS used_date, SUM(amount) AS used_amount
FROM gift_card_usage
WHERE status = 'SUCCESS'
GROUP BY gift_card_id, DATE(used_at)
) u ON g.id = u.gift_card_id AND DATEDIFF(DATE(u.used_date), "2026-01-10") <= 0
WHERE DATEDIFF(DATE(g.activated_at), "2026-01-10") <= 0
AND DATEDIFF(DATE(g.expired_at), "2026-01-10") > 0;
SELECT
"2026-01-10",
SUM(g.face_value) - COALESCE(SUM(u.used_amount), 0) AS active_balance
FROM (
SELECT id, face_value, activated_at, expired_at
FROM gift_card
) g
LEFT JOIN (
SELECT gift_card_id, DATE(used_at) AS used_date, SUM(amount) AS used_amount
FROM gift_card_usage
WHERE status = 'SUCCESS'
GROUP BY gift_card_id, DATE(used_at)
) u ON g.id = u.gift_card_id AND u.used_date < DATE_ADD(CAST("2026-01-10" AS DATETIME), INTERVAL 1 DAY)
WHERE g.activated_at < DATE_ADD(CAST("2026-01-10" AS DATETIME), INTERVAL 1 DAY)
AND g.expired_at >= DATE_ADD(CAST("2026-01-10" AS DATETIME), INTERVAL 1 DAY);
WITH date_list AS (
SELECT '2026-01-01' AS stat_date
UNION ALL
SELECT '2026-01-02'
UNION ALL
SELECT '2026-01-03'
UNION ALL
SELECT '2026-01-04'
UNION ALL
SELECT '2026-01-05'
UNION ALL
SELECT '2026-01-06'
UNION ALL
SELECT '2026-01-07'
UNION ALL
SELECT '2026-01-08'
UNION ALL
SELECT '2026-01-09'
UNION ALL
SELECT '2026-01-10'
)
SELECT
d.stat_date,
SUM(g.face_value) - COALESCE(SUM(u.used_amount), 0) AS active_balance
FROM date_list d
CROSS JOIN (
SELECT id, face_value, activated_at, expired_at
FROM gift_card
) g ON g.activated_at < DATE_ADD(CAST(d.stat_date AS DATETIME), INTERVAL 1 DAY) AND g.expired_at >= DATE_ADD(CAST(d.stat_date AS DATETIME), INTERVAL 1 DAY)
LEFT JOIN (
SELECT gift_card_id, DATE(used_at) AS used_date, SUM(amount) AS used_amount
FROM gift_card_usage
WHERE status = 'SUCCESS'
GROUP BY gift_card_id, DATE(used_at)
) u ON g.id = u.gift_card_id AND u.used_date <= d.stat_date
GROUP BY d.stat_date
ORDER BY d.stat_date;
WITH date_list AS (
SELECT '2026-01-01' AS stat_date
UNION ALL SELECT '2026-01-02'
UNION ALL SELECT '2026-01-03'
UNION ALL SELECT '2026-01-04'
UNION ALL SELECT '2026-01-05'
UNION ALL SELECT '2026-01-06'
UNION ALL SELECT '2026-01-07'
UNION ALL SELECT '2026-01-08'
UNION ALL SELECT '2026-01-09'
UNION ALL SELECT '2026-01-10'
),
card_snapshot AS (
SELECT d.stat_date, g.id AS gift_card_id, g.face_value
FROM date_list d
CROSS JOIN gift_card g ON g.activated_at < DATE_ADD(CAST(d.stat_date AS DATETIME), INTERVAL 1 DAY) AND g.expired_at >= DATE_ADD(CAST(d.stat_date AS DATETIME), INTERVAL 1 DAY)
),
usage_snapshot AS (
SELECT d.stat_date, u.gift_card_id, SUM(u.amount) AS used_amount
FROM date_list d
CROSS JOIN gift_card_usage u ON u.used_at < DATE_ADD(CAST(d.stat_date AS DATETIME), INTERVAL 1 DAY) AND u.status = 'SUCCESS'
GROUP BY d.stat_date, u.gift_card_id
)
SELECT
c.stat_date,
SUM(c.face_value) - COALESCE(SUM(u.used_amount), 0) AS active_balance
FROM card_snapshot c
LEFT JOIN usage_snapshot u ON c.stat_date = u.stat_date AND c.gift_card_id = u.gift_card_id
GROUP BY c.stat_date
ORDER BY c.stat_date;