Kafka从系统架构到生产消费的完整图谱
Kafka 架构
Kafka 生产与消费
Q & A
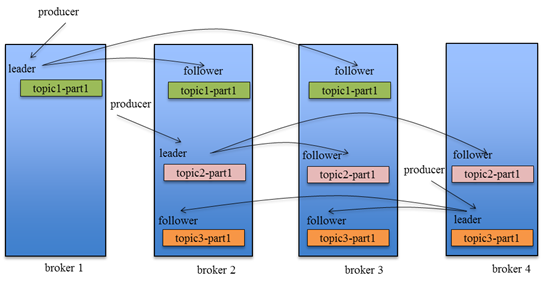
- Broker、Topic、Partition、Leader、Follower 等概念之间的关系是怎样的?
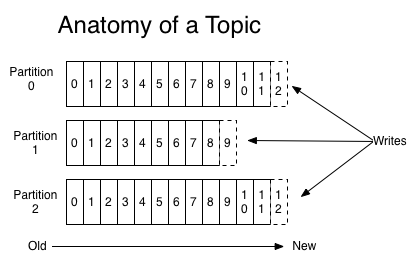
- Topic 的分区结构与写入过程是怎样的?
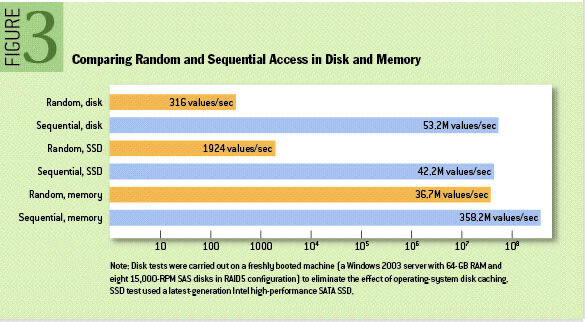
- 顺序IO跟随机IO在不同存储介质上的性能是怎样的?
- Topic 在磁盘上的目录文件结构是怎样的?
下图即名为 “click” 的 Topic 在磁盘上的目录结构,它有3个 Partition。
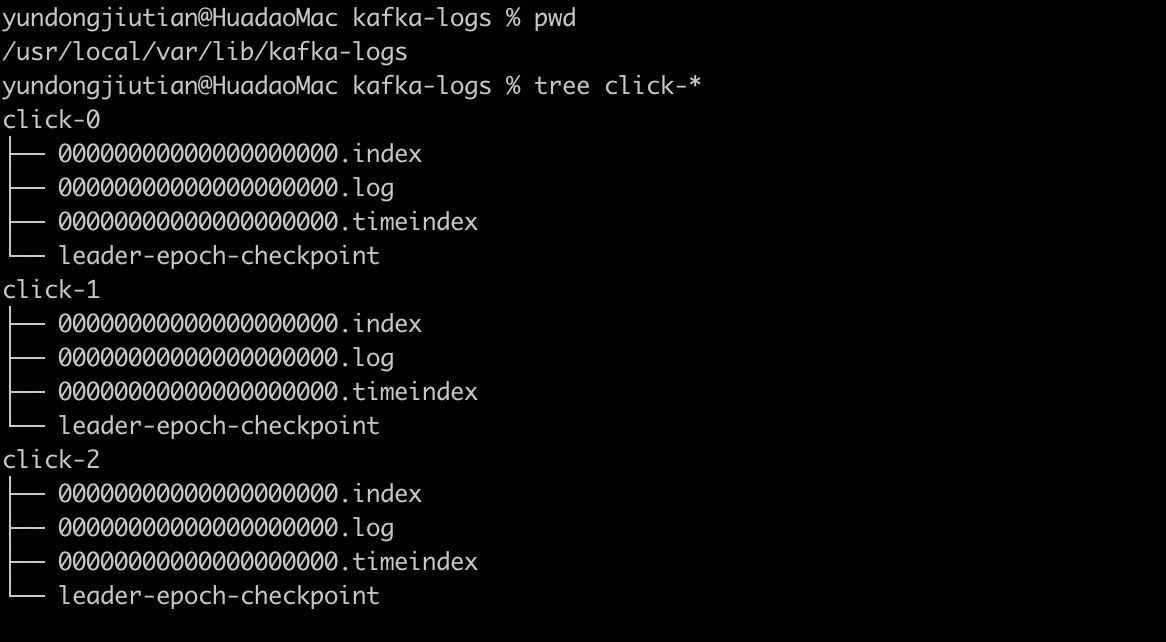
一个 Partition 在磁盘上对应一个文件夹,里面通常包含多组文件,每组被称为一个日志段(LogSegment)。
一个日志段由多个文件组成:
.log日志文件,是实际存储消息体的文件;.index稀疏索引文件,建立了 “消息逻辑偏移量(Offset) → 消息物理磁盘位置” 的映射,用于快速定位消息;.timeindex时间戳索引文件,建立了 “消息时间戳 → 消息逻辑偏移量(offset)” 的映射,方便按时间范围来查找消息。- 如何根据 Offset 在日志文件中查找消息?
以下图为例,查找 Offset 为 7 的 Message
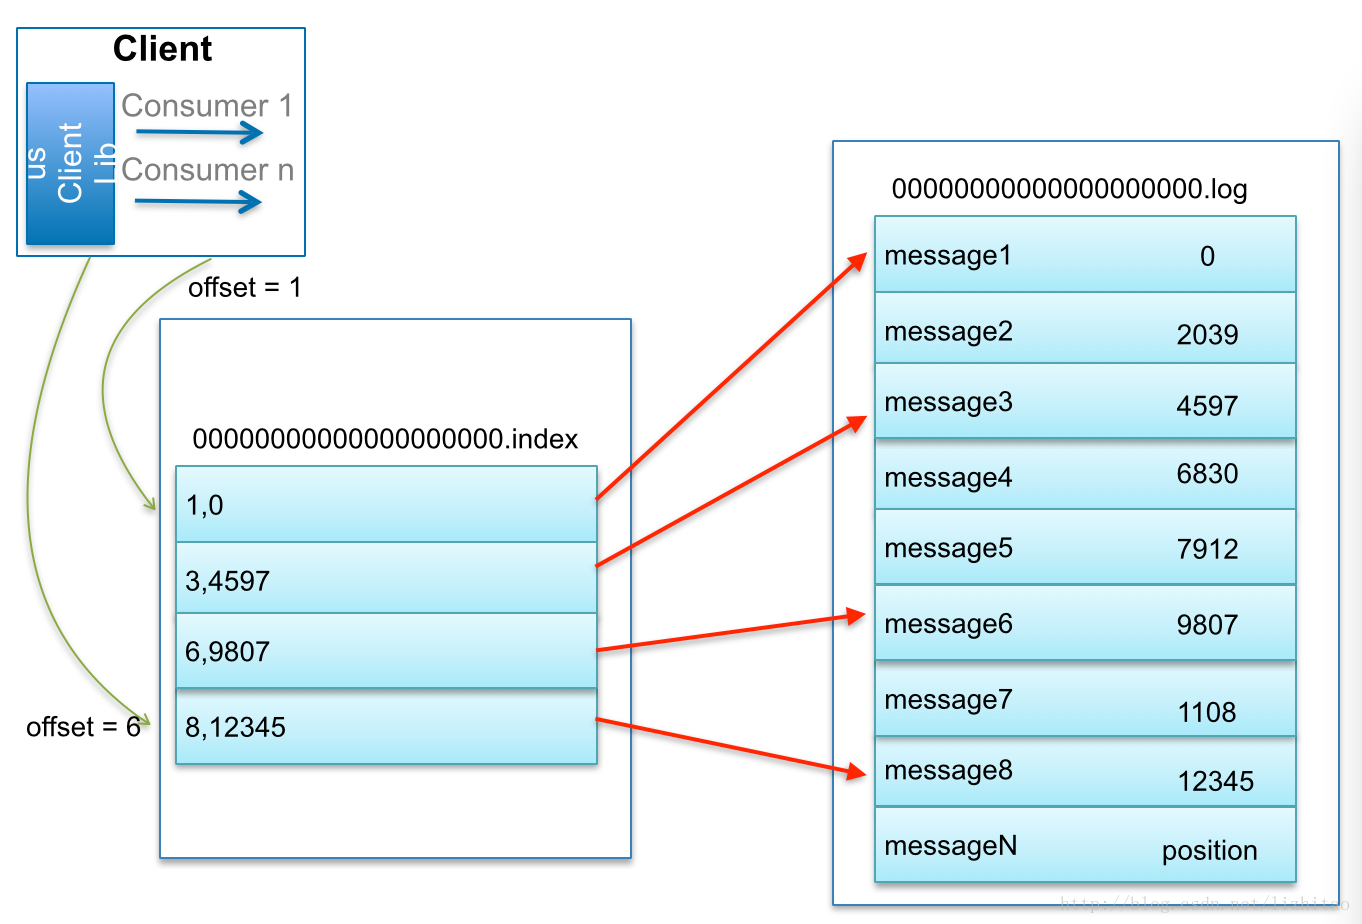
查找步骤
因为 LogSegment 根据内部最小的 Offset 命名。
所以首先使用二分查找,确定 Message 在哪个 LogSegment 中。
打开
.index稀疏索引文件,使用二分查找,找到最接近 Offset 7 且小于等于 Offset 7 的那个 Offset,本例为 Offset 6。上一步已经知道 Offset 6 对应消息的物理位置为 9807,接下来打开
.log文件,从 9807 的位置开始,顺序扫描,直到找到 Offset 7 对应的消息。本例中即物理位置 1108 这条消息。
- Broker 中消息写入与持久化流程是怎样的?
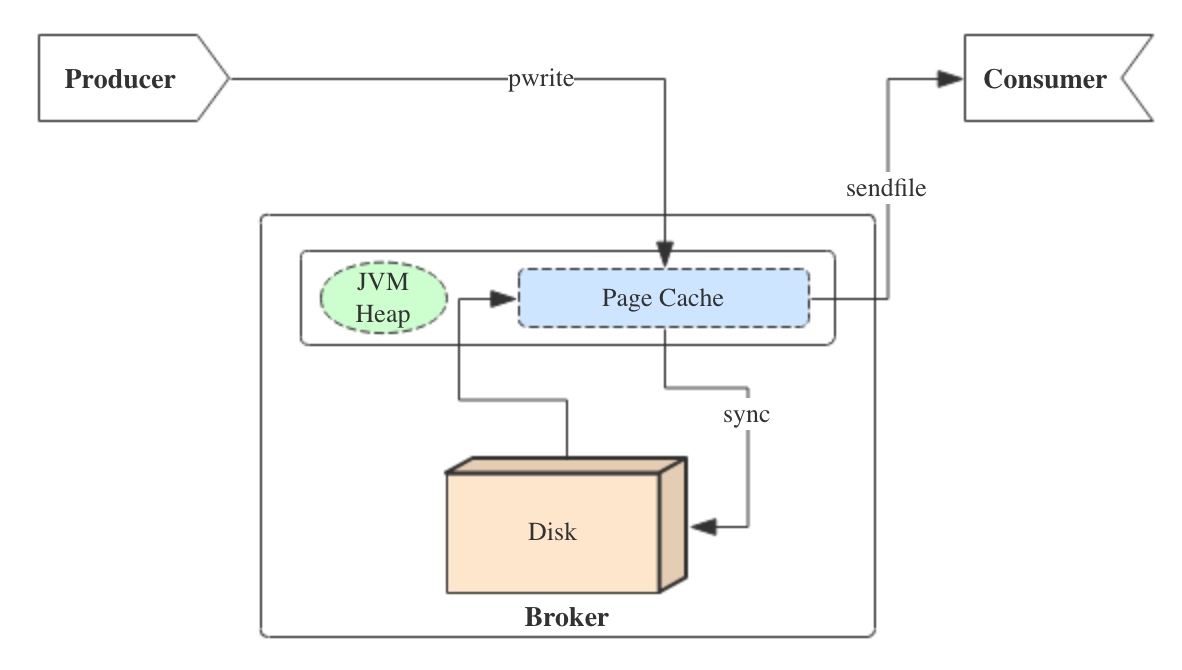
- Kafka 为什么要把数据直接写到硬盘,而不是写到内存再 flush?
现代操作系统主动将所有空闲内存用作 disk caching, 所有对磁盘的读写操作都会通过这个统一的 cache。如果不使用直接I/O,该功能不能轻易关闭。
因此即使进程维护了 in-process cache,该数据也可能会被复制到操作系统的 Page Cache 中,事实上所有内容都被存储了两份。
Kafka 是建立在 jvm 上面的,jvm 有两个特点:
对象的内存开销非常高,通常是所存储的数据的两倍(甚至更多)
随着堆中数据的增加,Java 的垃圾回收变得越来越复杂和缓慢
简化代码,因为所有保持 cache 和文件系统之间一致性的逻辑现在都被放到了 OS 中,这样做比一次性的进程内缓存更准确、更高效。
- Page Cache 的数据什么时候回写硬盘?
Linux 内核里负责回写脏页的线程称为 flusher 线程。
flusher 线程运行时机:
空闲内存低于某个阈值
脏页停留时间高于某个阈值
用户进程主动调用sync()或fsync()
进一步得出结论: 只要数据写进了 Page Cache,即使 Kafka 进程挂掉,数据也不会丢失
- Page Cache 什么时候读取硬盘?
当 Consumer 要消费的消息不在 Page Cache 里,才会去磁盘读取。
并且会顺便预读出一些相邻的块放入 Page Cache,以方便下一次读取。
进一步得出结论:如果 Producer 的生产速率与 Consumer 的消费速率相差不大,那么就能几乎只靠对 Page Cache 的读写完成整个生产-消费过程,磁盘访问非常少。这个结论俗称为“读写空中接力”。
- Sendfile 零拷贝相比传统网络IO有何优势?
传统网络IO流程
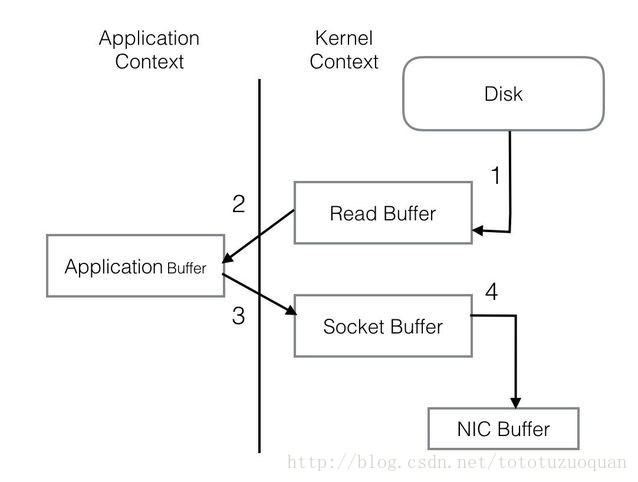
操作系统从磁盘读取数据到内核空间的 Page Cache。
应用程序读取内核空间的数据到用户空间的缓冲区。
应用程序将数据(用户空间的缓冲区)写回内核空间到套接字缓冲区(内核空间)。
操作系统将数据从套接字缓冲区(内核空间)复制到通过网络发送的 NIC 缓冲区。
Sendfile 零拷贝
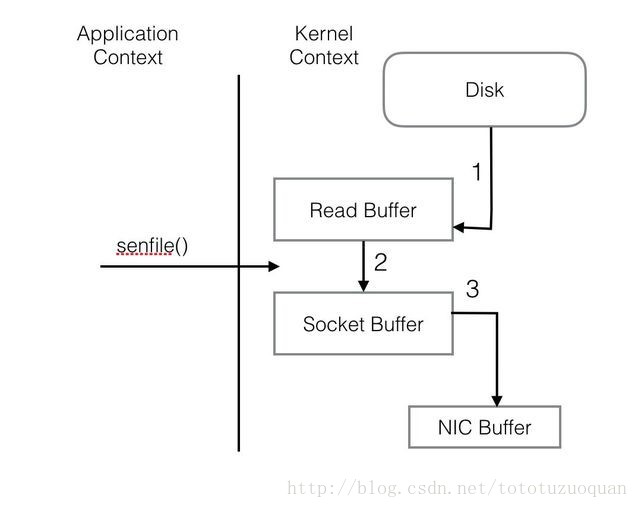
数据直接从 Page Cache 发送到网络,将IO操作全部交给操作系统,减少数据复制。
- 如何分配 Partition 和 Replica 到 Broker 上?
分配过程
将所有 Broker(假设共 n 个 Broker)和待分配的 Partition 排序。
将第 i 个 Partition 分配到第
个 Broker 上。 将第 i 个 Partition 的第 j 个 Replica 分配到第
个 Broker 上。
进一步得出结论:若 Replica 的数量大于 Broker 的数量,会有两个相同的 Replica 分配到同一个 Broker 上,所以 Replica 的数量应该小于等于 Broker 的数量。
- Producer 生产消息的可靠性怎么保证?
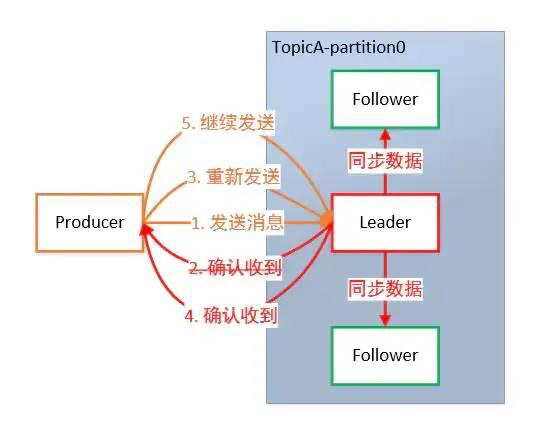
数据发送的可靠性机制
Partition-Leader 收到 Producer 发送的数据。
Partition-Leader 将数据同步到 Partition-Follower。
Partition-Leader 向 Producer 返回 ACK(ACKnowledge 确认收到)信号
- 多少个 Replica (Leader+Follower) 同步完成后发送 ACK?
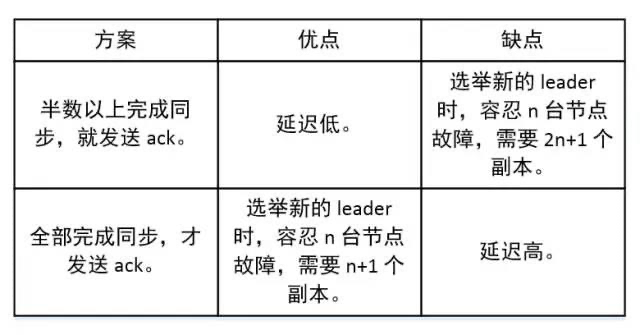
Kafka 选择后者,但严格来说应该是全部 Replica 的一个同步子集,即 ISR (a set of in-sync replicas)
- 什么是 ISR 机制?
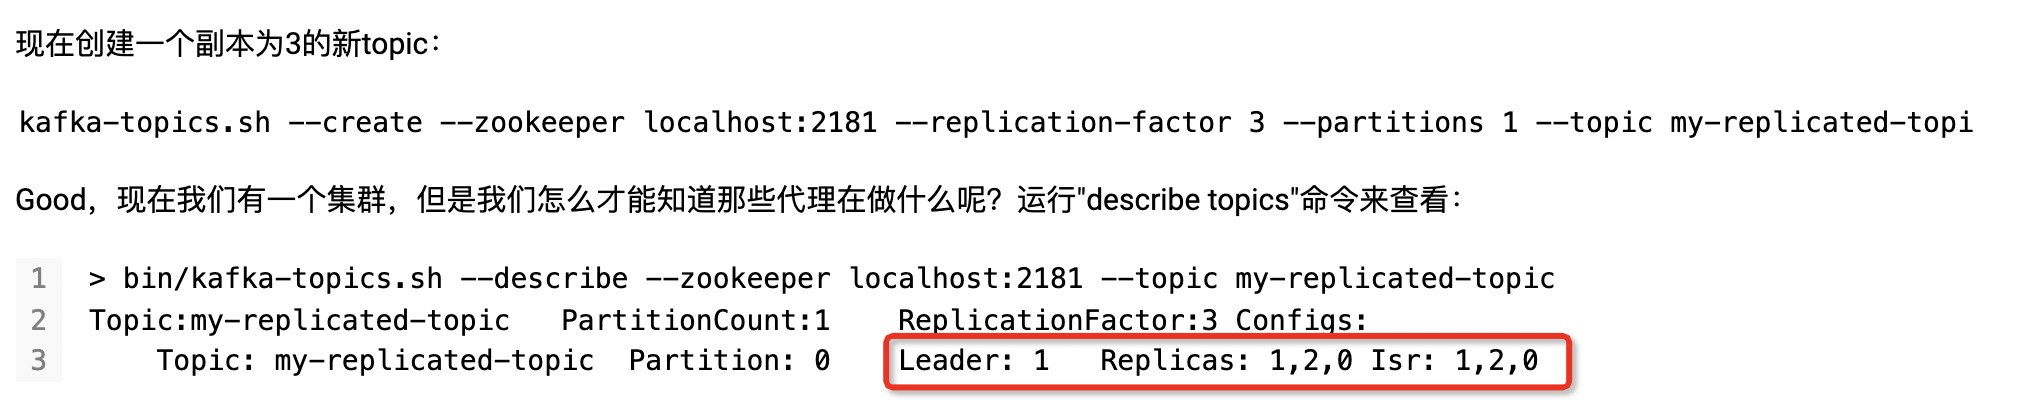
ISR 概念解释
ISR 是 Replicas 的一个子集。
Follower 长时间不同步,会踢出 ISR。
Leader 故障, 会从 ISR 中重新选择 Leader。
ISR 中所有 Follower 完成数据的同步之后,Leader 向 Producer 返回 ACK。
ISR 集合发生变化会在 ZooKeeper 持久化。
ISR 中的任何一个节点都有资格被选为 Leader。
- 满足什么条件的 Replica 才会变成 ISR 的成员?
它所在的 Broker 需要能在 Zookeeper 里维护心跳。
它和 Leader 之间的数据差异不能太大,这个差异是一个可配置的 threshold。
满足以上条件的 Follower 被称之为 “in sync”。
- Producer 生产消息的可靠性有几个级别?
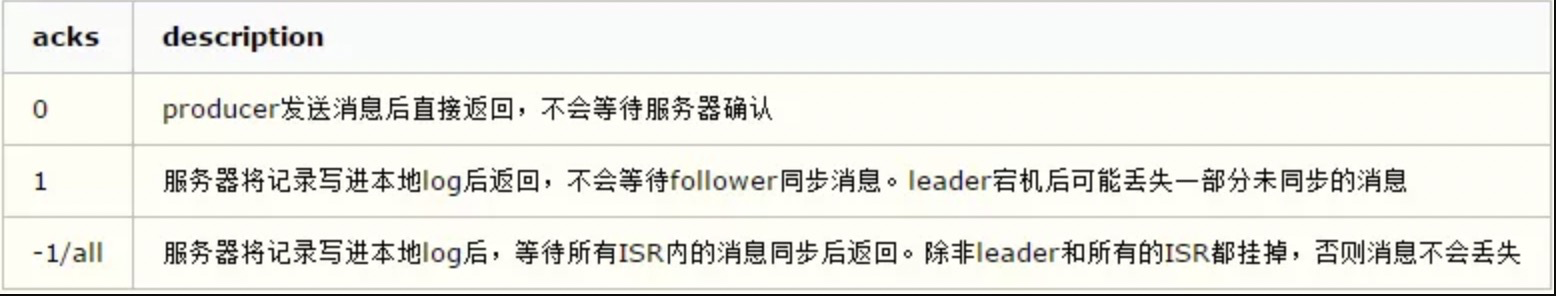
- Kafka 的故障恢复机制是怎样的?
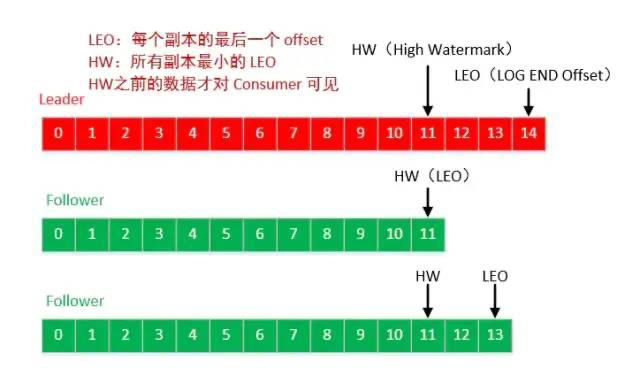
Follower故障: 被临时踢出ISR,恢复后先截掉本地日志中高于上次HW的部分,再从HW开始同步Leader数据。
Leader故障: 从ISR中选新Leader,其他Follower先截掉高于HW的日志,再同步新Leader数据。
全部节点故障: Kafka会选第一个恢复的副本(不一定在ISR中)作为Leader。
- Producer 发送消息时的路由机制是怎样的?
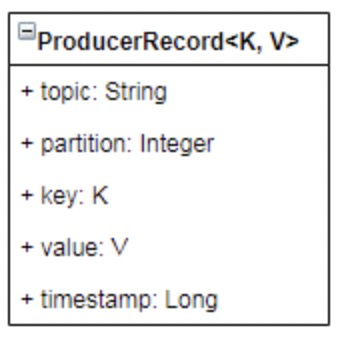
图为 Kafka 发送的 Message 的内部结构
消息路由机制
指定了 Partition,则直接使用。
没有指定 Partition 但有 Key,将 Key 的 Hash 值与分区数取余得到 Partition 值。
既没有 Partition 也没有 Key 的情况下,第一次调用时随机生成一个整数(后面每次调用都在这个整数上自增),将这个值与可用的分区数取余,得到 Partition 值,也就是常说的 Round-Robin 轮询算法。
- Producer 的消息发送方式有几种?
异步发送: 确定目标分区后,发送到一块内存缓冲区中(发送队列)。Producer 的另一个工作线程(即 Sender 线程),负责实时地从该缓冲区中提取出准备好的消息封装到一个批次内,统一发送到对应的 Broker 中。
同步发送: 不分批,直接发送到 Broker,一条消息发送一次,直到收到 ACK 信号才开始发送下一条消息。
- Consumer 支持几种消费模式?
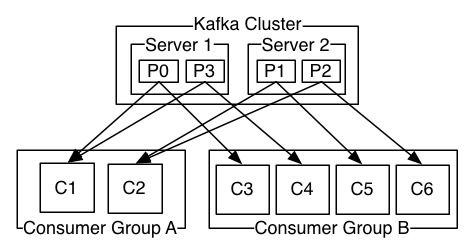
队列模式(queuing): 多个 Consumer 可以同时从服务端读取消息,每个消息只被其中一个 Consumer 读到 (消息竞争)。
发布-订阅模式 (publish-subscribe): 消息被广播到所有的 Consumer 中 (消息共享)。
Consumer Group,组内消息竞争,组间消息共享。
- Rebalance 触发时机是什么时候?
Group 中的 Consumer 分配 Partition 的过程叫 Rebalance。它的触发时机有以下几种:
组成员个数发生变化。
订阅的 Topic 个数发生变化。
订阅的 Topic 分区数发生变化。
- Offset 从语义上来看有几种?
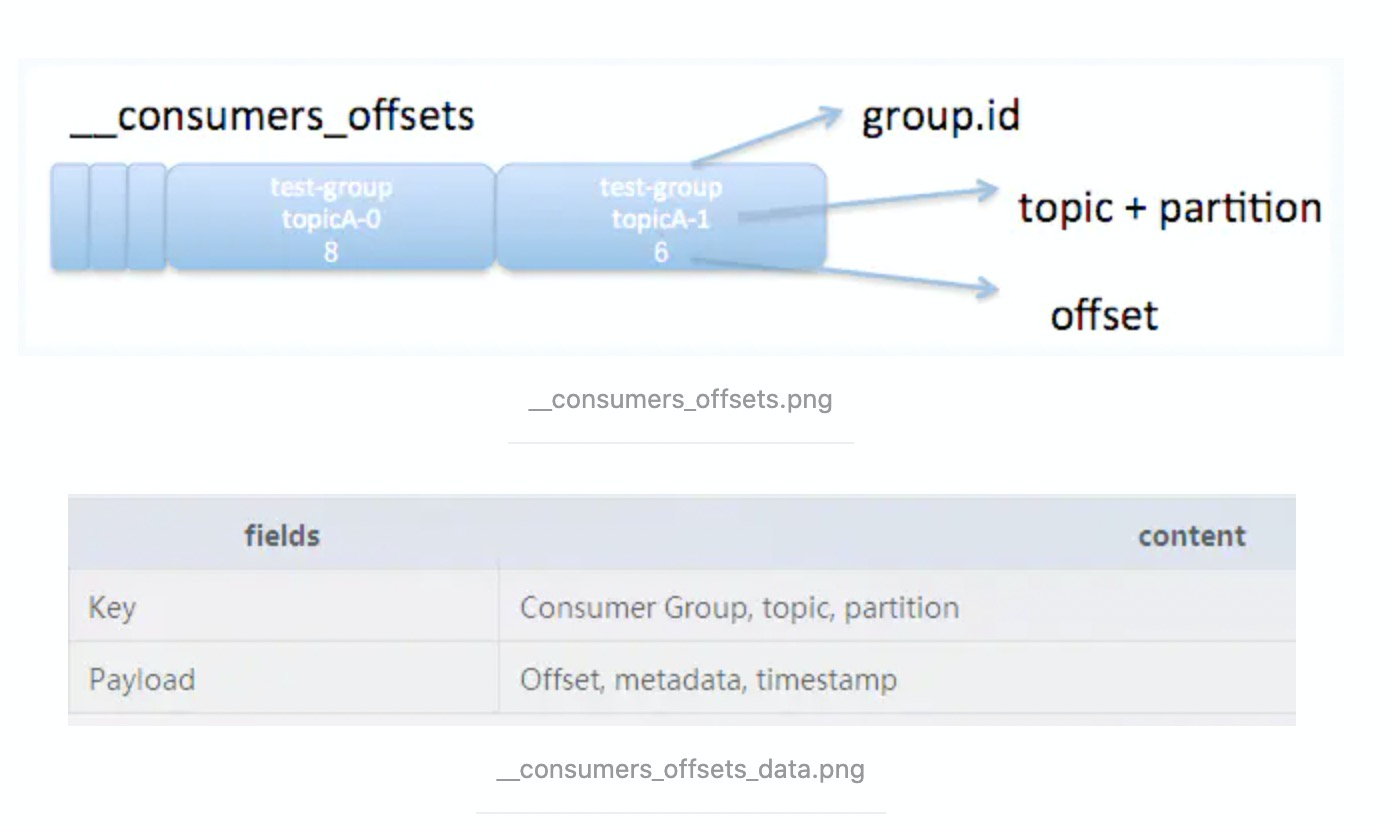
Committed Offset: 代表 Consumer 已经确认消费过的消息的序号,持久化保存在 Broker 的 一个特殊 Topic: __consumers_offsets 上。
Current Offset: Consumer 希望收到的下一条消息的序号,存在于 Consumer 客户端中(未持久化)。